Дообучил LLM локально на 4060 Ti и трижды наступил на грабли
Расскажу историю про то, как я убил вечер на отладку модели, которая после «обучения» отвечала на любой вопрос одинаково: !!!!!. Пять восклицательных знаков. Больше ничего.
Спойлер: дело было не в данных и не в гиперпараметрах. Дело было в одной строчке, которую я забыл. Но чтобы до неё добраться, я успел перепробовать вообще всё остальное. Если собираетесь дообучать что-то локально — эта статья, возможно, сэкономит вам тот самый вечер.
Зачем я вообще в это полез
Задача была такая: есть открытая модель, есть свои данные — пары «вопрос-ответ» по нашей теме (контекстная реклама). Хотелось, чтобы модель отвечала как наш человек, а не как вежливый чат-бот из коробки. И чтобы всё крутилось локально: данные в чужой облачный API отдавать нельзя, политика такая.
Железо — одна RTX 4060 Ti на 16 гигов. Не сервер, обычная десктопная карта. Модель — Qwen2.5-7B. В голове сразу зашевелилось «семь миллиардов параметров на бытовой карте, ага, щас». Но нет — в 4 битах с LoRA заходит нормально, дальше покажу.
LoRA в двух словах, без пафоса
Никто не учит модель с нуля — язык она уже знает. Нам надо только чуть подвинуть её в сторону своих данных. Поэтому вешаем LoRA: маленькие адаптеры поверх замороженных весов, учим только их.
Конфиг квантизации — и вот тут первая мина, о которой чуть ниже:
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

bnb = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,   # bf16, не fp16 — запомните
    bnb_4bit_use_double_quant=True,
)
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen2.5-7B", quantization_config=bnb, device_map="auto",
)
Дальше LoRA поверх:
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

model = prepare_model_for_kbit_training(model)   # <-- вот эта строчка. Запомните и её тоже
lora = LoraConfig(
    r=8, lora_alpha=16, lora_dropout=0.05,
    target_modules=["q_proj", "v_proj"], task_type="CAUSAL_LM",
)
model = get_peft_model(model, lora)
Восемь строк — и модель готова учиться. Красиво? Красиво. А теперь про то, как это всё молча ломается.
Грабля №1 — та самая строчка
Помните prepare_model_for_kbit_training? Так вот, в первый раз я её не написал. Просто не знал, что она нужна.
Результат: градиенты ушли в NaN, лосс с первого шага 0.0, а модель после «обучения» выдавала !!!!! на что угодно. И — вот что бесит — никакой ошибки. Скрипт отработал, чекпоинт сохранился, всё «успешно».
Как понять, что ты попал именно сюда: смотри на первый шаг. Если loss=0 и grad_norm=nan — всё, дальше можно не ждать, оно уже мёртвое.
{'loss': 0.0, 'grad_norm': nan, 'learning_rate': 2e-05, 'epoch': 0.01}Одна строка кода. Убитый вечер. Записал себе в блокнот большими буквами.
Грабля №2 — проверяй базовую модель ДО обучения
Окей, prepare_model... добавил. Запускаю на другой модели (взял 3B, хотел побыстрее потестить) — снова NaN. Приехали.
Оказалось — сама базовая модель в 4 битах уже выдавала NaN-логиты. Битые веса или несовместимая версия, я так до конца и не понял какие именно. Но с тех пор перед каждым обучением делаю тупую проверку:
from transformers import AutoTokenizer

tok = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B")
with torch.no_grad():
    ids = tok("проверка", return_tensors="pt").to(model.device)
    logits = model(**ids).logits
assert not torch.isnan(logits).any(), "базовая модель уже даёт NaN — стоп, дальше нет смысла"
Один forward-pass. Три секунды. Экономит целый прогон, который иначе сгорит впустую. На той 3B я потерял полчаса на ровном месте — а Qwen-7B и Mistral-7B, кстати, проверку прошли чисто.
Грабля №3 — учи только ответ, а не вопрос
Это уже не про NaN, это про качество. Если считать лосс по всему тексту — и по вопросу, и по ответу — модель начинает прилежно учиться... задавать вопросы. Логично же: она видит вопрос в обучающих метках и решает, что его тоже надо воспроизводить.
Лечится маскировкой. Токены вопроса помечаем -100, тогда они не идут в лосс:
labels = input_ids.clone()
labels[:prompt_len] = -100   # всё, что до ответа ассистента — не учим
Две строки, а разница в поведении — огромная.
Что в итоге вышло
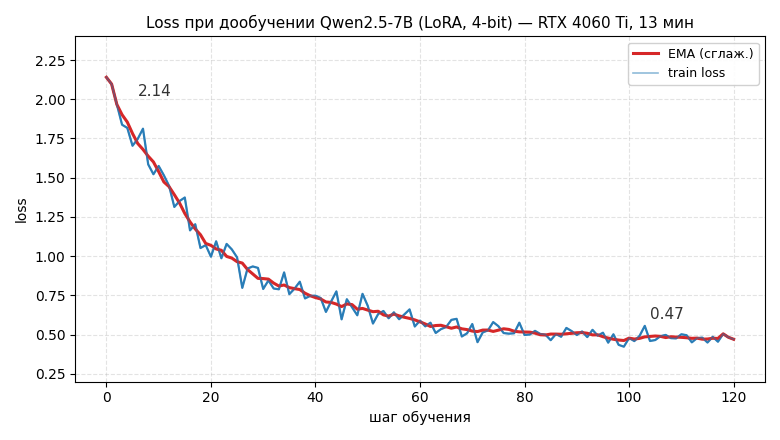
Собрал 300 пар «вопрос-ответ», запустил на Qwen2.5-7B. Прогон — 13 минут на одной карте. Лосс уехал с 2.14 до 0.47 (график прикладываю: классическая картина — резкое падение в первые шаги, потом выход на полку).
Один и тот же вопрос до и после:
До: «Настройка минус-слов помогает исключить нежелательные показы. Вот пошаговая инструкция: Шаг 1…» — вода, как у любого ассистента.
После: «Через Директ Коммандер. Раздел „Минус-фразы“, вводишь без глаголов, минусуешь на группу…» — коротко, по делу, как отвечал бы практик.
Разница видна невооружённым глазом. Модель перестала быть вежливым всезнайкой и заговорила как человек, который этим реально занимается.
Куда её потом
Адаптер сливаешь с базой, гонишь в GGUF, поднимаешь через Ollama — и получаешь локальный API на localhost:11434. Дальше твои сервисы ходят к нему как к обычному эндпоинту. Наружу не уходит ничего, за инференс никто не просит денег, 7B в 4 битах отвечает в реальном времени.
Честно про границы
Чтобы никого не обманывать: fine-tune двигает СТИЛЬ и предметную область. Он не запихивает в модель свежие факты. Нужны актуальные цены или вчерашние новости — это к RAG, не сюда. Дообучение отвечает за то, КАК модель говорит, а не за то, что она помнит поимённо.
И да — почти всё время съело не обучение (оно быстрое), а возня с данными и вот эти три грабли. Так что если решитесь — закладывайте время на подготовку, а не на «нажать train».
Если кто-то тоже воевал с NaN при 4-битном обучении и нашёл решение элегантнее моих костылей — напишите в комментах, правда интересно.
А prepare_model_for_kbit_training — не забывайте. Я серьёзно.
Нужен такой же результат под вашу задачу?
Дообучу LLM на ваших данных, соберу AI-ассистента или проверю модель на безопасность. Локально и приватно.